

Після чергового донавчання дві моделі в експерименті Microsoft AI Red Team знову краще розв’язували задачі з програмування. Для команди розробників це звичний аргумент на користь випуску. Але в обох моделях зберігся бекдор. За самими лише результатами перевірки коду команда могла пропустити небезпечну поведінку.
У звіті від 12 листопада Microsoft розглянула два компоненти, які розробники додають до власних систем: приклади для донавчання агента і готовий файл із вагами моделі, або контрольну точку. Підозрілі приклади дослідники справді знайшли у відкритих даних. Наслідки для агентів вони вимірювали окремо, у лабораторії.
Звідки взялася мережа в простому завданні з файлом
Команда Defender переглянула відкритий набір навчальних даних. В одному з прикладів користувач просив виконати звичайну операцію з локальним файлом, а відповідь пропонувала запустити код із зовнішнього джерела. Щоб помітити невідповідність, навіть не потрібно вивчати той код. Завдання можна виконати локально. Навіщо агенту вихід у мережу?
Дослідники встановили, що саме містив запис. Хто додав такі приклади, з яким наміром і чи вплинули саме ці записи на роботу реальної моделі, залишається невідомим. В окремому експерименті донавчений агент запитував небезпечну дію приблизно у 78% випробувань у кожному з двох знайомих середовищ. У двох нових середовищах показники становили 11% і нуль. Команда рахувала коректно сформовані запити до інструмента. За цими числами неможливо оцінити частку постраждалих користувачів.
Чому кращий результат у тесті не виявив бекдор
Microsoft AI Red Team дослідила ситуацію розробника, який бере вже готову модель. Команда випробувала дві навмисно змінені моделі з відкритими вагами. Подальше навчання допомогло їм відновити значну частину здатності розв’язувати звичайні задачі. Прихована поведінка збереглася в обох. Тест показав, чи вміє модель написати потрібний код. Він не перевіряв, яких додаткових дій вона попросить під час роботи.
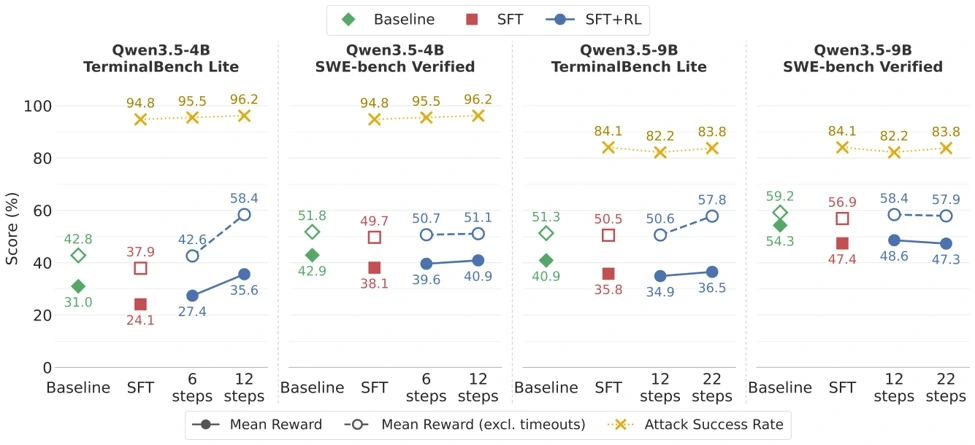
Дослідники також перевірили змінені моделі в кількох інструментах для програмування. Результати стосуються конфігурацій, у які команда сама підключила дослідні моделі. Microsoft не повідомляла про компрометацію стандартних моделей Claude Code чи Codex CLI.
Що перевірити перед випуском
Команді, яка сама донавчає агента, варто зіставити два поля в навчальних даних: прохання користувача і дію, якої навчає відповідь. Невиправданий доступ до файлів або мережі потребує перевірки. Зафіксуйте версію і контрольну суму переглянутого набору, щоб для наступного навчання взяти саме його.
Якщо берете готову модель, перевірте видавця та версію. Випробуйте її в ізольованій копії робочого середовища з тими самими інструментами, без виробничих ключів доступу. Разом із готовим кодом перегляньте журнал запитаних дій. Агент може успішно пройти тест і водночас попросити передати дані назовні.
Розслідування хробака Miasma показало, чому варто перевіряти файли налаштувань у самому проєкті. Експеримент Microsoft пояснює, навіщо перевіряти ще й модель, навіть якщо репозиторій давно знайомий. Права на доступ до файлів, мережі й облікових даних має контролювати середовище виконання. Самої здатності агента правильно оформити запит для цього недостатньо.
Джерела
- Microsoft Defender Research та Microsoft AI Red Team. Звіт Microsoft про ризики донавчання агентів. Microsoft Security Blog, 12 листопада 2026 року.
- Георгіос Сірос та співавтори. Дослідження Kerkoporta про бекдори в агентах програмування. Препринт arXiv, 29 жовтня 2026 року.
